Domain studio-equipment.de kaufen?
Wir ziehen mit dem Projekt
studio-equipment.de um.
Sind Sie am Kauf der Domain
studio-equipment.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain studio-equipment.de kaufen?
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **

Ähnliche Suchbegriffe für Text-to-Speech
Top-Angebote
Produkte zum Begriff Text-to-Speech:
-
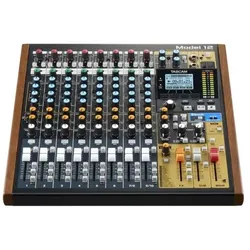
Tascam Model 12 Mischpult mir Interface mit Kabel (Studio- und Livemixer), Mischpult, SchwarzDas Tascam Model 12 ist ein vielseitiges Mischpult, das speziell für Musiker, Multimedia-Schaffende, Songwriter und Solokünstler entwickelt wurde. Es kombiniert die Funktionalität eines analogen Mischpults mit den Vorteilen digitaler Aufnahme- und Produktionssysteme. Mit zehn Eingängen, einem integrierten 12-Spur-Audiorecorder und einem USB-Audio-Interface bietet es eine umfassende Lösung für die Tonmischung und -aufnahme. Die intuitive Bedienoberfläche ermöglicht eine einfache Handhabung, während die Unterstützung für MIDI-Geräte und spezielle Podcasting-Funktionen wie Mix-Minus und Smartphone-Eingang den kreativen Prozess bereichern. Das Model 12 ist ideal für Studio- und Live-Anwendungen und bietet eine hohe Audioqualität mit einer Samplerate von 48 kHz und einer Auflösung von 24 Bit. Es ist ein kompaktes und leistungsstarkes Werkzeug, das den Anforderungen moderner Musikproduktion gerecht wird. - Integrierter 12-Spur-Audiorecorder mit WAV-Dateien bis 48 kHz und 24 Bit - MIDI-Schnittstelle für die Verbindung mit MIDI-fähigen Geräten - Podcasting-Funktionen wie Mix-Minus und Smartphone-Eingang - Gleichzeitige Nutzung des USB-Audio-Interfaces und des internen Recorders - Platzsparendes Design mit analogen Bedienelementen und digitaler Effizienz.706,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Krause, Benjamin: Hate SpeechHate Speech , Strafbarkeit und Strafverfolgung von Hasspostings , Scheinwerfer-Vorschaltgeräte & Zündgeräte > Beleuchtung , Auflage: 1. Auflage, Erscheinungsjahr: 20221021, Produktform: Kartoniert, Autoren: Krause, Benjamin, Auflage: 22001, Auflage/Ausgabe: 1. Auflage, Seitenzahl/Blattzahl: 114, Keyword: Hasskriminalität; Silencing; Radikalisierung, Fachschema: International (Recht)~Internationales Recht~Strafrecht, Fachkategorie: Strafrecht, allgemein, Warengruppe: TB/Strafrecht, Fachkategorie: Internationales Öffentliches Recht: Strafrecht, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: XII, Seitenanzahl: 114, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: C.H. Beck, Verlag: C.H. Beck, Verlag: Verlag C.H. Beck oHG, Länge: 236, Breite: 157, Höhe: 12, Gewicht: 252, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: 0, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch,39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Aiseesoft PDF to Text ConverterPDF zu Text Konverter kann Ihnen helfen, PDF in TXT-Format mit hoher Qualität und schneller Geschwindigkeit zu konvertieren Die besten PDF zu Text Konvertierung Software zu konvertieren PDF in Text-Datei in hoher Qualität, so dass Sie PDF-Dateien bearbeiten und lesen PDF-Inhalte leichter auf eBook-Reader. PDF in Text konvertieren Dieser PDF to Text Converter kann PDF in Textdateien umwandeln, so dass Sie PDF-Inhalte auf allen gängigen Android-Geräten oder eBook-Readern lesen können. Hohe PDF-Dateisicherheit Sie brauchen keine Plug-ins zu installieren und können das PDF-Quelldokument auch ohne Internetverbindung in eine Textdatei umwandeln. Benutzerfreundliche Schnittstelle PDF to Text Converter ist mit einer sehr übersichtlichen Benutzeroberfläche ausgestattet, die es Ihnen ermöglicht, PDF-Dateien mit wenigen Klicks in Textdateien zu konvertieren. PDF in Textdatei ko...24,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **


Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
Was ist die Bedeutung von "text to speech 123458"?
"Text to Speech 123458" ist wahrscheinlich eine Beschreibung oder ein Name für eine Software oder einen Dienst, der Text in Sprache umwandelt. Es könnte sich um eine spezifische Version oder Variante handeln, die möglicherweise bestimmte Funktionen oder Eigenschaften bietet. Ohne weitere Informationen ist es jedoch schwierig, die genaue Bedeutung zu bestimmen. **
Top-Angebote
Produkte zum Begriff Text-to-Speech:
-
Roland Aira E-4 Vocal Effektgerät mit Kopfhörer (Studio- und Livemixer), MischpultDas Roland Aira E-4 Vocal Effektgerät ist ein vielseitiges Werkzeug für die Bearbeitung und Verbesserung von Gesangsperformances. Es bietet eine breite Palette an professionellen Effekten, die es ermöglichen, die Stimme kreativ zu transformieren und zu verfeinern. Mit Funktionen wie Auto Pitch, Harmony und Vocoder können Benutzer ihre Vocals auf innovative Weise gestalten. Die kompakte Bauweise und die robuste Konstruktion machen das Gerät ideal für den mobilen Einsatz, während der integrierte Lithium-Ionen-Akku eine Betriebsdauer von bis zu 3,5 Stunden pro Aufladung bietet. Die benutzerfreundliche Oberfläche mit intuitiven Reglern und Tasten ermöglicht eine einfache Handhabung, sodass sowohl Anfänger als auch erfahrene Benutzer schnell zu beeindruckenden Ergebnissen gelangen können. Der E-4 ist nicht nur für Livestreams und Podcasts geeignet, sondern auch für Live-Performances und Musikproduktionen, wodurch er sich als unverzichtbares Werkzeug für kreative Künstler erweist. - Vielseitige Vocal-Effekte wie Auto Pitch, Harmony und Vocoder - 24-Sekunden-Looper mit unbegrenzten Overdubs und automatischer BPM-Erkennung - Scatter-Regler für einzigartige rhythmische Effekte - Umfangreiche Gainsteuerung für Mikrofoneingang - Robuste Konstruktion für den mobilen Einsatz.244,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer599,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Tascam Model 12 Mischpult mir Interface mit Kabel (Studio- und Livemixer), Mischpult, SchwarzDas Tascam Model 12 ist ein vielseitiges Mischpult, das speziell für Musiker, Multimedia-Schaffende, Songwriter und Solokünstler entwickelt wurde. Es kombiniert die Funktionalität eines analogen Mischpults mit den Vorteilen digitaler Aufnahme- und Produktionssysteme. Mit zehn Eingängen, einem integrierten 12-Spur-Audiorecorder und einem USB-Audio-Interface bietet es eine umfassende Lösung für die Tonmischung und -aufnahme. Die intuitive Bedienoberfläche ermöglicht eine einfache Handhabung, während die Unterstützung für MIDI-Geräte und spezielle Podcasting-Funktionen wie Mix-Minus und Smartphone-Eingang den kreativen Prozess bereichern. Das Model 12 ist ideal für Studio- und Live-Anwendungen und bietet eine hohe Audioqualität mit einer Samplerate von 48 kHz und einer Auflösung von 24 Bit. Es ist ein kompaktes und leistungsstarkes Werkzeug, das den Anforderungen moderner Musikproduktion gerecht wird. - Integrierter 12-Spur-Audiorecorder mit WAV-Dateien bis 48 kHz und 24 Bit - MIDI-Schnittstelle für die Verbindung mit MIDI-fähigen Geräten - Podcasting-Funktionen wie Mix-Minus und Smartphone-Eingang - Gleichzeitige Nutzung des USB-Audio-Interfaces und des internen Recorders - Platzsparendes Design mit analogen Bedienelementen und digitaler Effizienz.706,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Krause, Benjamin: Hate SpeechHate Speech , Strafbarkeit und Strafverfolgung von Hasspostings , Scheinwerfer-Vorschaltgeräte & Zündgeräte > Beleuchtung , Auflage: 1. Auflage, Erscheinungsjahr: 20221021, Produktform: Kartoniert, Autoren: Krause, Benjamin, Auflage: 22001, Auflage/Ausgabe: 1. Auflage, Seitenzahl/Blattzahl: 114, Keyword: Hasskriminalität; Silencing; Radikalisierung, Fachschema: International (Recht)~Internationales Recht~Strafrecht, Fachkategorie: Strafrecht, allgemein, Warengruppe: TB/Strafrecht, Fachkategorie: Internationales Öffentliches Recht: Strafrecht, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: XII, Seitenanzahl: 114, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: C.H. Beck, Verlag: C.H. Beck, Verlag: Verlag C.H. Beck oHG, Länge: 236, Breite: 157, Höhe: 12, Gewicht: 252, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: 0, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch,39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
Ähnliche Suchbegriffe für Text-to-Speech
-
Aiseesoft PDF to Text ConverterPDF zu Text Konverter kann Ihnen helfen, PDF in TXT-Format mit hoher Qualität und schneller Geschwindigkeit zu konvertieren Die besten PDF zu Text Konvertierung Software zu konvertieren PDF in Text-Datei in hoher Qualität, so dass Sie PDF-Dateien bearbeiten und lesen PDF-Inhalte leichter auf eBook-Reader. PDF in Text konvertieren Dieser PDF to Text Converter kann PDF in Textdateien umwandeln, so dass Sie PDF-Inhalte auf allen gängigen Android-Geräten oder eBook-Readern lesen können. Hohe PDF-Dateisicherheit Sie brauchen keine Plug-ins zu installieren und können das PDF-Quelldokument auch ohne Internetverbindung in eine Textdatei umwandeln. Benutzerfreundliche Schnittstelle PDF to Text Converter ist mit einer sehr übersichtlichen Benutzeroberfläche ausgestattet, die es Ihnen ermöglicht, PDF-Dateien mit wenigen Klicks in Textdateien zu konvertieren. PDF in Textdatei ko...24,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
the t.bone Speech 100 Mthe t.bone Speech 100 M, Steuerzentrale für digitales Konferenzsystem, 2 Gruppen für jeweils bis zu 16 Sprechstellen, Feedbackunterdrückung, USB Aufnahme und Playback (*.mp3, Datenträger bis 32 GB), 4 Diskussionsmodi (3, 6, 9 oder alle Mikrofone können gleichzeitig aktiviert werden), Abstimmungs-Modus, 2x Stereo Rec Out (Cinch), 1x Stereo Out für Soundsystem (Cinch), 1x Stereo In (Cinch), 1x Mic In (XLR mit Phantomspeisung), 1x LAN, Abmessungen: 19" / 2HE, 32cm Einbautiefe, Gewicht 5,5 kg; passendes Case: Art. 496024 (nicht im Lieferumfang enthalten); passender Booster für mehr als 16 Sprechstellen je Linie: Art. 498125 (nicht im Lieferumfang enthalten)469,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
the t.bone Speech 100 Cthe t.bone Speech 100 C, Chairman, Präsidentensprechstelle für digitales Konferenzsystem, Kondensatormikrofon, LCD-Display, Tasten für Abstimmung, eingebauter Lautsprecher mit Lautstärkeregelung, Kopfhöreranschluss, Prioritätssteuerung für Präsidentensprechstelle, 2x LAN (In/Link), Mikrofon-Schwanenhalslänge ca. 40 cm, 1x 2m Netzwerkkabel im Lieferumfang enthalten, Abmessungen: 169 x 46 x 175 mm (B x H x T), Gewicht 0,7 kg198,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
-
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
-
Was ist die Bedeutung von "text to speech 123458"?
"Text to Speech 123458" ist wahrscheinlich eine Beschreibung oder ein Name für eine Software oder einen Dienst, der Text in Sprache umwandelt. Es könnte sich um eine spezifische Version oder Variante handeln, die möglicherweise bestimmte Funktionen oder Eigenschaften bietet. Ohne weitere Informationen ist es jedoch schwierig, die genaue Bedeutung zu bestimmen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.